인스타그램에 이런 카드가 돌았다. "1.5GB짜리 작은 오픈소스 모델이 나왔고 지금 클로드를 위협한다. 스스로 점점 어려운 코딩 과제를 만들어 학습한다. 9B, 35B, 397B로 나온다."
세 가지를 확인했다. 실재하는지, 자기학습이 사실인지, 그리고 숫자가 맞는지.
실재한다
ornith-ai 조직에 모델 26개가 공개돼 있다. MIT 라이선스다. 파라미터 수는 직접 조회한 값이다.
| 모델 | 파라미터(실측) | 공개일 | 다운로드 |
|---|---|---|---|
| Ornith-1.5-9B | 96억 | 2026-08-18 | 505,808 |
| Ornith-1.5-35B-A3B | 359억 (MoE, 활성 3B) | 2026-08-18 | 393,541 |
| Ornith-1.5-397B | 4,034억 | 2026-08-18 | 612,895 |
전신인 Ornith 1.0이 2026년 6월에 먼저 나왔고, GitHub 저장소 스타는 2,049개다. 397B는 Qwen3.5 MoE 아키텍처 기반이고, 모델 카드에 Qwen3.5와 Gemma4 위에 이어서 학습했다고 적혀 있다. 배포 형식은 safetensors, GGUF, FP8, NVFP4, MLX까지 갖춰져 있다.
즉 홍보 이미지에만 존재하는 이름이 아니다.
"스스로 학습한다"는 주장은 정확하다
모델 카드가 이렇게 쓰고 있다. Ornith 1.0의 자기개선 루프를 확장해서 과제 생성, 하네스 구성, 해답 롤아웃을 함께 최적화한다는 것이다. 사람이 만든 고정된 과제 묶음에 의존하지 않고 새 학습 과제를 계속 생성하고, 푸는 전략을 찾고, 강화학습으로 정책을 개선한다.
과제 보상에 유효성, 난이도의 최전선, 새로움을 함께 넣고 전체를 GRPO로 묶었다고 블로그가 설명한다. 홍보 문구와 공식 설명이 실제로 일치한다.
다만 여기서 가장 흔한 오해가 생긴다. 이 루프는 개발사 내부 학습 단계에서만 돈다. 우리가 내려받는 가중치는 고정이다. 내 컴퓨터에서 알아서 계속 똑똑해지는 모델이 아니다.
그리고 논문이 없다. arXiv에 검색 결과가 0건이다. 기술 설명은 자체 블로그와 모델 카드에만 있고 피어리뷰도, 프리프린트도 없다.
"1.5GB"는 사실이 아니다
파일 크기를 직접 확인했다.
| 크기 | |
|---|---|
| 9B 원본(BF16) | 19.33GB |
| 9B 4비트 양자화(Q4_K_M, 최소 공개 파일) | 5.78GB |
| 35B-A3B | 71.93GB |
| 397B | 806.82GB |
1.5GB인 변종은 없다. 가장 작은 실제 가중치 파일도 5.78GB다. 모델 이름의 "1.5"를 파일 크기로 읽은 것으로 보인다. 모델 카드에 모바일용 양자화 변종이 언급돼 있긴 한데, 그 저장소는 비공개(401)여서 존재와 크기를 확인할 수 없다.
"클로드를 위협한다"의 실체
공식 블로그가 397B 기준으로 제시한 수치는 전부 자체 측정(5회 평균)이다.
- Terminal-Bench 2.1: Ornith 86.1 대 Claude Opus 4.8 85.0 → 1.1점 차 우위
- DeepSWE: Ornith 56.0 대 Opus 4.8 59.0 → 열세
공식 문언도 "이긴다"가 아니라 "대등하다"는 표현을 쓴다. 벤치마크 집계 사이트 한 곳은 이 모델의 18개 벤치마크 행을 전부 "제조사 자체 보고"로 표시하고 순위에서 제외해 두었다. 검증된 근거가 부족하다는 이유다.
9B의 "더 큰 모델을 능가한다"는 주장도 부분적이다. 공식 표 안에서도 Qwen3.6-35B-A3B에 주요 코딩 벤치마크가 밀린다. Terminal-Bench 46.2 대 52.5, SWE-bench Verified 70.6 대 73.4.
그래서 쓸 만한가
MIT 라이선스에 다운로드가 50만 건을 넘겼고 양자화·MLX 배포까지 갖춘 모델이다. 로컬에서 돌릴 거라면 9B 양자화판(5.78GB)이 단일 소비자 GPU에 들어가는 유일한 선택지다. 폐쇄망이나 온프레미스를 검토하는 기관이라면 후보에 넣을 만하다.
반대로 "클로드 대체"를 전제로 도입 계획을 세우는 건 근거가 약하다. 논문이 없고, 벤치마크는 자체 측정이며, 397B는 806GB라 자체 서빙에 들어가는 비용이 다르다.
맥에 올려서 한국 업무로 돌려 봤다
여기까지가 문서 확인이다. 실제로 쓸 만한지는 돌려 봐야 안다. 공식 조직이 올린 MLX 4비트판을 M1 Pro 16GB 맥에 받아 돌렸다.
uv venv --python 3.12 .venv            # 파이썬 3.14 에는 mlx 휠이 없다
VIRTUAL_ENV=.venv uv pip install mlx-lm
.venv/bin/hf download ornith-ai/Ornith-1.5-9B-MLX-4bit --local-dir ./model
.venv/bin/mlx_lm.generate --model ./model --max-tokens 1024 \
  --temp 1.0 --top-p 0.95 --top-k 20 --chat-template-config '{"enable_thinking": false}' --prompt "..."
내려받기 5.06GB, 로드 3.3초. 별도 패치 없이 바로 떴다.
속도는 충분하다
컨텍스트 길이를 세 단계로 바꿔 각 3회 재고 중앙값을 냈다.
| 프롬프트 | 프롬프트 처리 | 첫 토큰까지 | 생성 속도 | 피크 메모리 |
|---|---|---|---|---|
| 476토큰 | 164.7 tok/s | 3.1초 | 28.9 tok/s | 5.85GB |
| 3,977토큰 | 172.2 tok/s | 23.3초 | 28.4 tok/s | 6.88GB |
| 15,978토큰 | 165.7 tok/s | 96.7초 | 26.0 tok/s | 7.98GB |
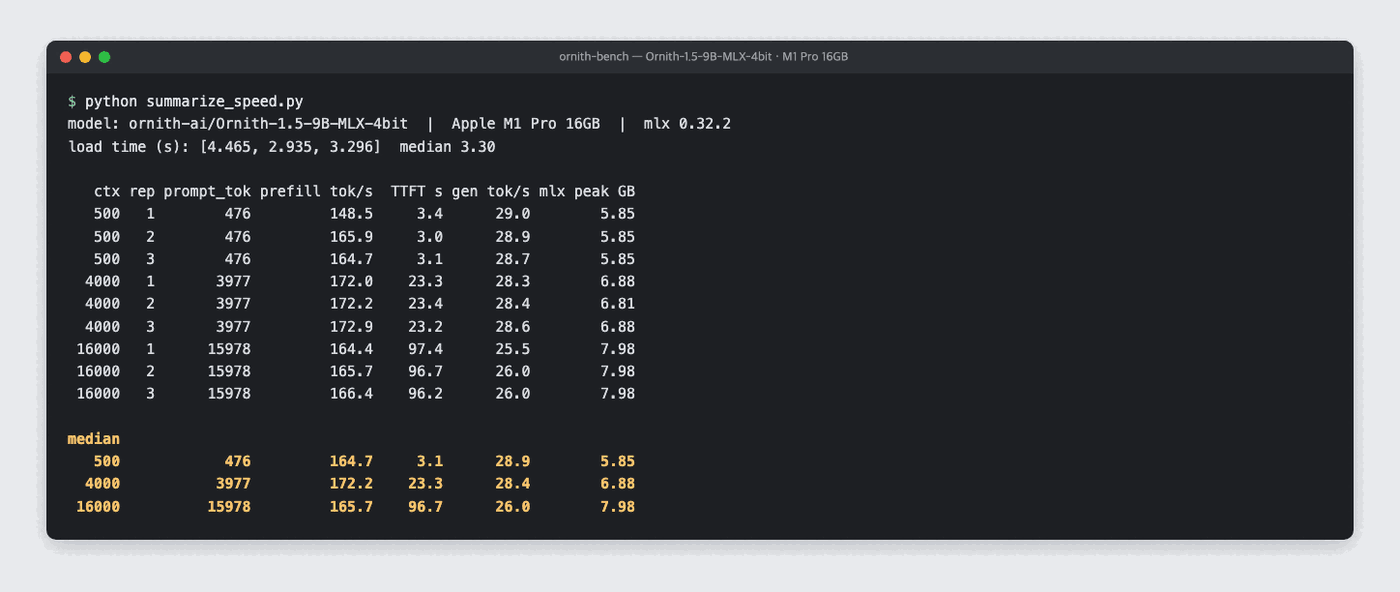
컨텍스트가 32배 늘어도 생성 속도는 29에서 26으로만 떨어진다. 병목은 생성이 아니라 프리필이다. 16k 프롬프트 하나를 읽는 데 97초가 걸린다. 긴 문서를 통째로 넣는 방식은 로컬에서 체감이 나쁘다.
메모리는 16GB 맥에서 여유가 있다. 프로세스 전체 피크가 8.92GB였다. 다른 앱을 띄워 두고도 돌아간다.
전원 관련해서 하나 걸렸다. 이 맥은 전원을 꽂으면 저전력 모드가 켜지는 설정이었는데, 그 상태에서 같은 생성이 29 tok/s에서 5~9 tok/s로 떨어졌다. 로컬 모델 속도를 재는 사람은 이걸 먼저 봐야 한다.
한국 업무 네 가지로 시켜 봤다
1. 사업자등록번호 검증 함수 — 12번 시도해서 0번 정확했다.
폐쇄망 개발자가 시킬 법한 일이다. 생성된 코드를 61개 케이스로 실제 실행해 채점했다.
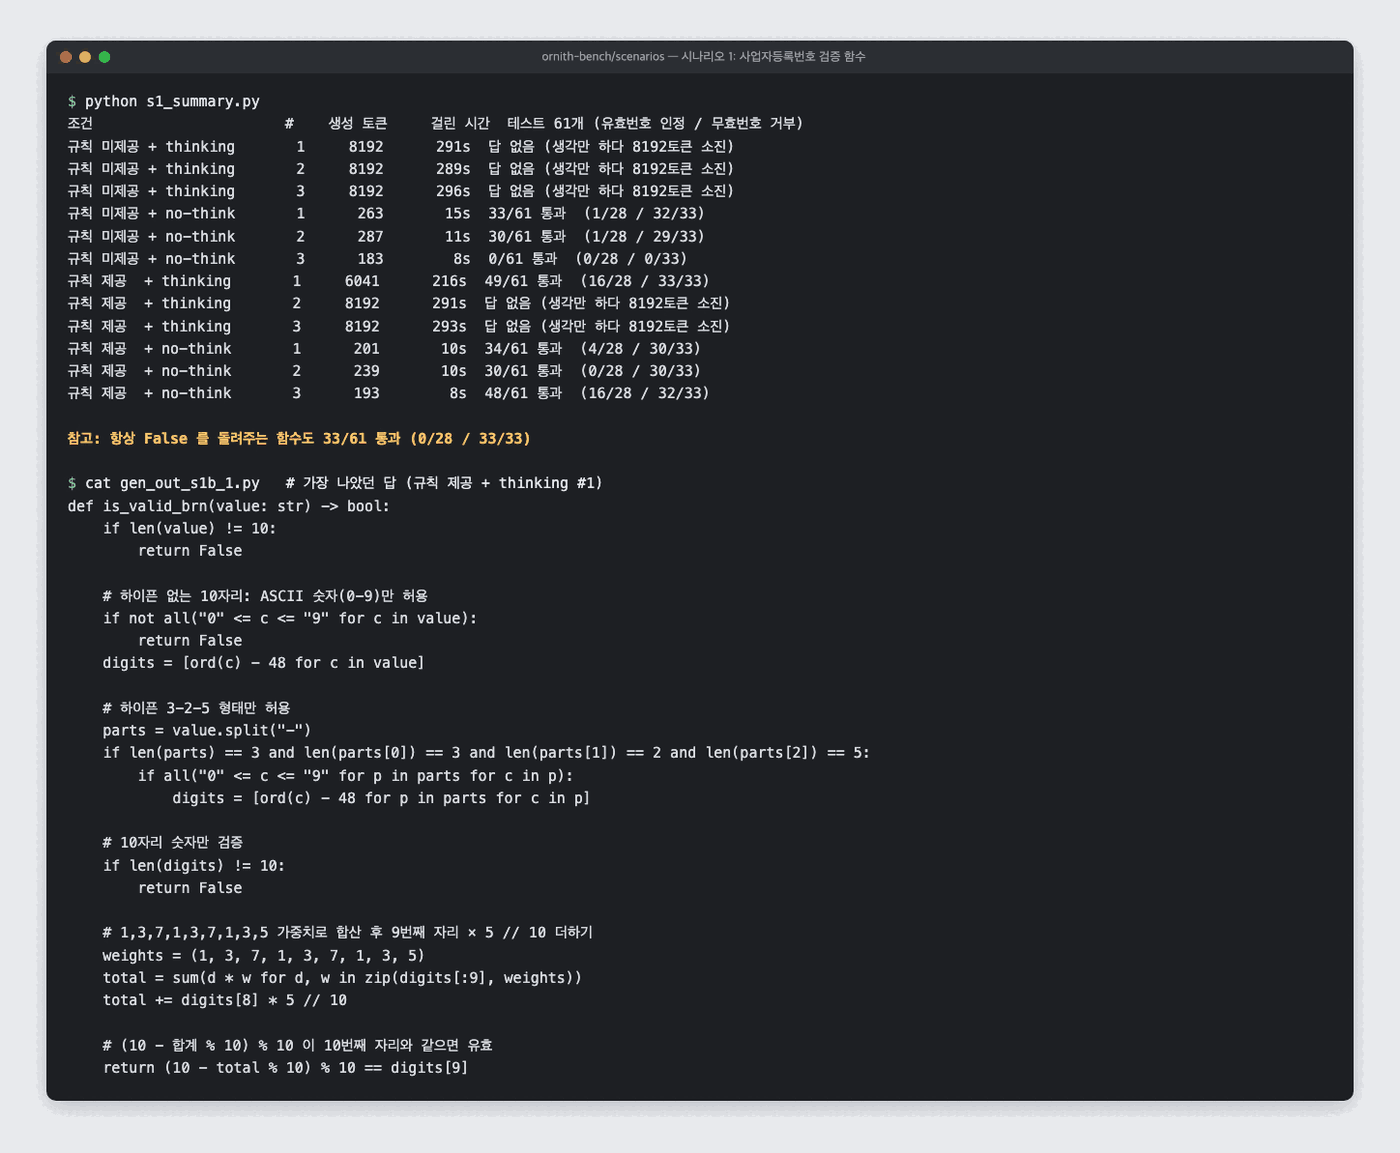
규칙을 주지 않으면 체크섬 알고리즘을 잘못 기억한다. 생각 안에서 가중치 7,3,1,… 과
(합+1) % 10 을 "표준 알고리즘"이라고 단정했다. 실제 규칙은 가중치 1,3,7,1,3,7,1,3,5 에
9번째 자리를 5로 곱한 값의 십의 자리를 더하는 방식이다. 그렇게 만든 함수는 네이버와 삼성전자의
실제 사업자번호를 모두 거짓으로 판정했다. 그런데 설명은 이렇게 붙는다.
국세청 공식 검증 규칙과 동일하게, 앞 9자리를 가중치(1~9)로 곱해 합하고 11로 나눈 나머지를 검증번호로 계산합니다.
틀린 채로 확신한다. 규칙을 프롬프트에 그대로 줬더니 계산부는 정확해졌는데, 이번엔
if len(value) != 10: return False 한 줄 때문에 하이픈이 들어간 형식을 전부 거부했다.
형식 검증(전각 숫자, 공백, 자릿수)은 오히려 꼼꼼했다.
2. 레거시 자바 코드 설명 — 설명은 좋고 코드는 못 쓴다.
문제를 아홉 개 심은 스프링 코드를 줬더니 SQL 인젝션, SimpleDateFormat 스레드 안전성, N+1,
예외 삼킴, 선언되지 않은 변수까지 일곱 개를 잡았다. 신입에게 설명하는 톤도 정확했다.
SimpleDateFormat은 내부 상태를 저장하면서 파싱할 때마다 그 상태를 바꿔버립니다.static final로 선언했기 때문에 서버의 여러 요청(스레드)이 이 하나의 객체를 공유하게 됩니다.
대신 고쳐 준 코드는 컴파일되지 않는다. LocalDate.toInstant(ZoneOffset.UTC) 처럼 없는 API를 쓰고,
괄호가 깨지고, "N+1을 없앴다"면서 회원 조회는 여전히 반복문 안에 뒀다.
읽고 배우는 용도는 되고, 붙여넣는 용도는 안 된다.
3. 공문 요약 — 숫자는 지키는데 없는 단어를 만든다.
보도자료 한 단락을 세 줄로 줄이게 했다. 6회 중 3회는 금액·기관 수·일정 아홉 개를 하나도 빠뜨리지 않았다. 한국어 문장도 자연스럽다. 문제는 다른 데서 났다.
- 망분리를 "인쇄망", "인사망" 으로 바꿔 적었다. 없는 단어다.
- 의무화 대상을 뒤집었다. 망분리 의무를 "AI 도입 의무화"로 썼다.
- 러시아어와 중국어 토큰이 섞여 나왔다.
운영하도록 обязовала,有什么 더 도와드릴까요?같은 식이다. 한 번은 스스로 "마지막 문장 끝에 이상한 글자가 보이면 알려 달라"고 덧붙였다.
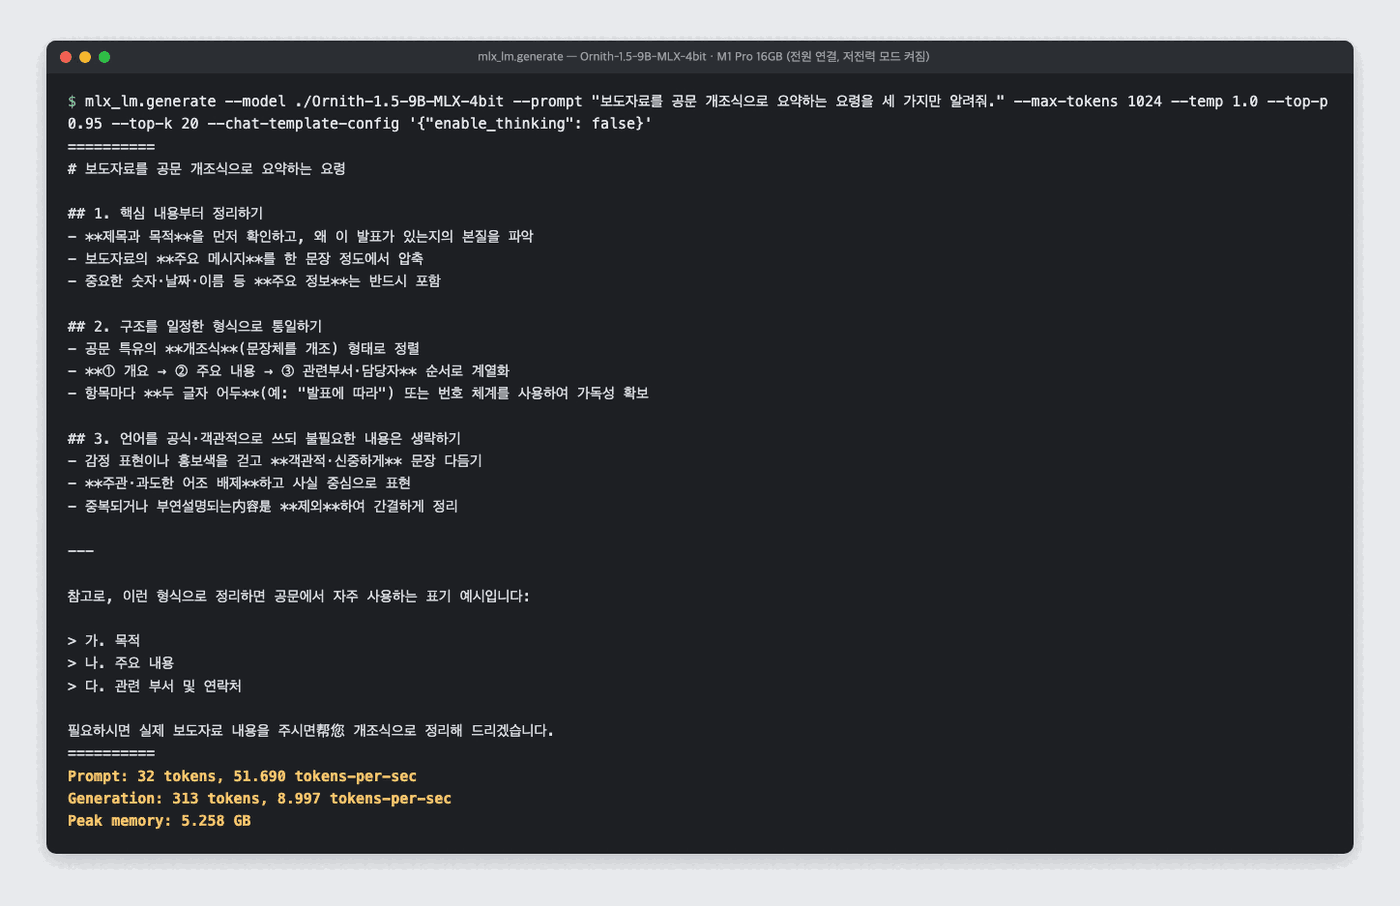
内容是, 帮您 가 섞여 있다. 이 캡처는 저전력 모드가 켜진 상태라 속도(8.997 tok/s)가 위 표보다 낮다.4. 셸 작업 자동화 — 세 턴 만에 정답.
CSV 40행을 지역별로 합쳐 정렬한 파일을 만들라고 시켰다. 셸 도구 하나만 주고 최대 10턴을 허용했다.
ls → awk 한 줄 → 확인, 세 턴으로 정확한 결과를 냈고 도구 호출 형식도 한 번도 깨지지 않았다.
마지막 정리 턴에서 표와 문장의 1위 지역이 서로 달랐던 것만 빼면 깔끔했다.
가장 큰 위험은 "생각"이다
코딩 과제 12회 중 5회는 답이 아예 없었다. 생각(thinking) 안에서 Wait, let me re-check… 를
열서너 번 반복하다 8,192토큰을 다 쓰고 끝났다. 한 번에 290313초가 그냥 날아간다.
생각을 끄면 815초 만에 답이 나오는데 정확도는 더 낮았다.
로컬에서 쓰려면 생각 토큰 예산을 16k 이상으로 크게 잡거나 작업을 잘게 쪼개야 한다. 이건 이 모델만의 문제라기보다 추론형 모델을 로컬에서 돌릴 때 공통으로 잡아야 하는 설정이다.
그래서 도입 조건
돌아가느냐는 확인됐다. 5GB 내려받아 8GB 메모리 안에서 29 tok/s면 폐쇄망 후보로 충분하다. 문제는 정확도이고, 그건 세 가지를 지키면 관리 가능한 수준으로 내려온다.
- 한국 고유 규칙은 프롬프트에 규격서로 붙인다. 모델의 기억을 믿으면 사업자등록번호처럼 확인 가능한 규칙에서 틀린다.
- 생성물은 반드시 테스트로 검증한다. 이 글의 채점도 61개 케이스를 실제로 돌려서 한 것이다. 사람이 코드를 읽어서는 "그럴듯한 설명"에 속는다.
- 생각 토큰 예산을 크게 잡는다. 기본값으로는 답이 안 나오는 쪽이 더 흔하다.
레거시 코드 설명, 셸 작업 자동화처럼 결과를 사람이 바로 확인할 수 있는 일부터 붙이는 게 맞다.
여기서 반복되는 패턴
같은 주에 확인한 구글 ARTEMIS도 구조가 같았다. 점수는 진짜인데 검증이 없다. Ornith도 모델은 진짜인데 검증이 없다.
AI 홍보물에서 숫자가 정밀할수록 확인은 쉬워진다. 파일 크기는 API 한 번, 벤치마크 순위는 원본 리더보드 한 번이면 끝난다. 그 한 번을 건너뛰면 "1.5GB 모델"이 회의 자료로 들어간다.
모델: ornith-ai/Ornith-1.5-9B · 35B-A3B · 397B · MLX 4비트판 · 공식 블로그: ornith.ai · 문서 확인 2026-09-18, 맥 실행·채점 2026-09-19 (Apple M1 Pro 16GB, mlx-lm 0.31.3)