코딩 에이전트에게 일을 시키면 매번 같은 일부터 한다. 저장소를 처음부터 훑는다. grep을 돌리고 파일을 열고 구조를 다시 파악한 다음에야 본론에 들어간다. 세션을 새로 열면 그 작업이 또 처음부터다.
Graft는 그 훑기를 한 번만 하고 결과를 지도로 남긴다. MIT 라이선스, 스타 8,386개다. 임베딩도, 유사도 검색도, 예열해 둘 인덱스도 없다.
이 사이트 저장소에 직접 붙여 봤다
이 블로그를 돌리는 저장소를 복제해서 그대로 돌렸다.
npm install -g @nanonets/graft   # graft 0.18.0
graft build .
결과는 이렇다.
✓ wiring: 189 nodes (126 function, 49 file, 13 type, 1 method), 361 edges, 49 cards
  parsed: 49 of 49 files (0 replayed from cache)
0.70초가 걸렸다. LLM 호출은 없다. tree-sitter로 파싱만 하기 때문이다.
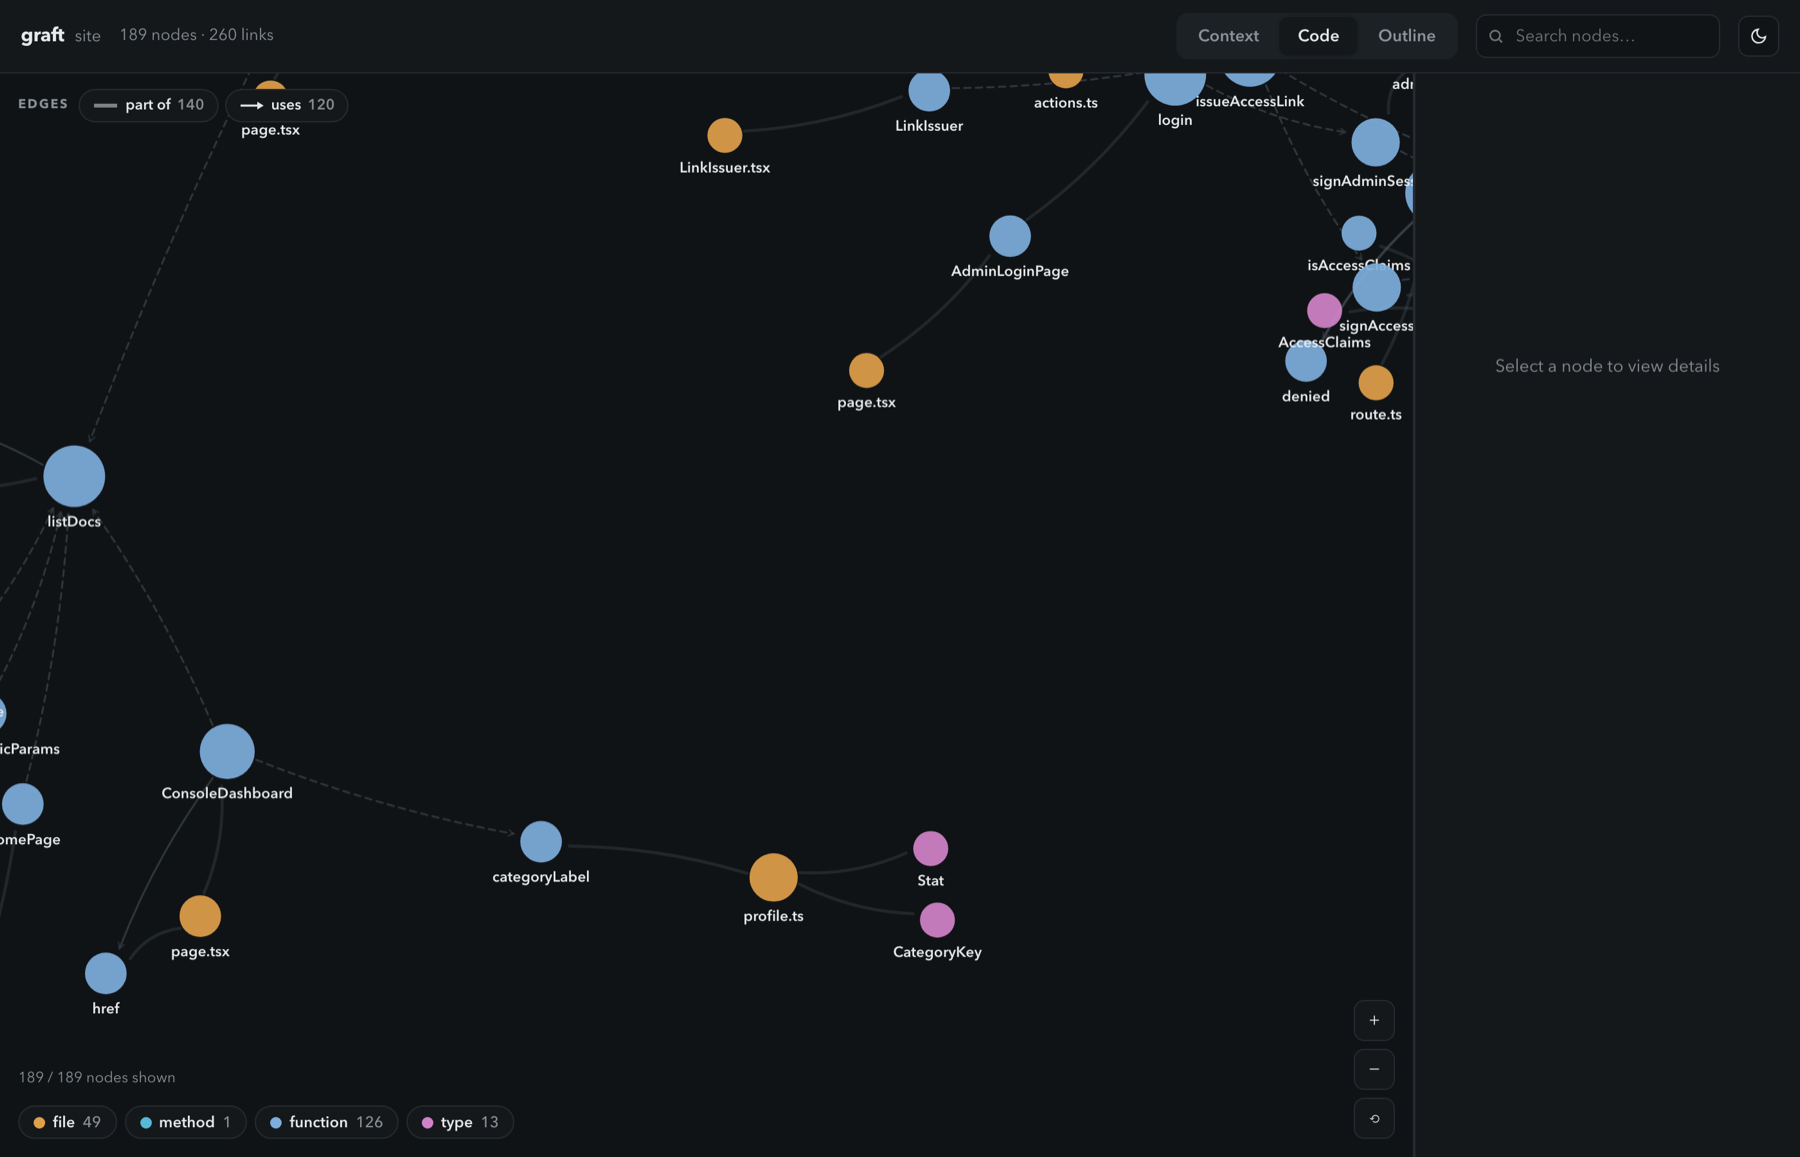
graft viz 로 띄운 실제 화면. 이 사이트 저장소의 함수·파일·타입 189개와 그 사이 연결이다. listDocs 를 중심으로 페이지들이 매달려 있는 모양이 그대로 보인다.그다음 구조 검색을 시켜 봤다. 이것도 모델을 부르지 않는다.
$ graft ask "how does the access gate verify tokens"
1. verifyAccess · function   src/lib/access.ts:L26-L31
2. verifyToken · function    src/lib/token.ts:L61-L98
3. verifyAdminSession        src/lib/admin.ts:L22-L27
4. issueAccessLink           src/app/admin/actions.ts:L15-L47
5. GET                       src/app/access/[token]/route.ts:L21-L63
6. proxy                     src/proxy.ts:L60-L104
0.25초. 토큰 소모 0. 실제로 내가 이 기능을 짠 파일 여섯 개를 정확히 집어냈다.
저장소 지도(graft map)도 읽을 만하다. 디렉터리별 파일·심볼 수와 함께 "허브"를 뽑아 준다.
이 저장소에서는 listDocs, getDoc, escapeHtml, renderDeck이 참조를 가장 많이 받는
함수로 나왔다. 실제로 그렇다.
어떻게 만드나
두 층으로 갈린다. 이 구분이 중요하다.
1층 — 구조 그래프. 순수 tree-sitter다. 모든 함수와 클래스, 호출 관계를 뽑는다.
모델 없음, API 키 없음, 네트워크 없음, 비용 0. build, map, ask, callers,
blast가 여기서 돈다.
2층 — 평문 설명. graft build --deep을 돌리면 LLM이 파일별 요약을 쓰고 노드를 묶어
depends_on, uses, implements 같은 관계를 붙인다. 여기서 처음 API 키가 필요하다.
자기 키, 자기 모델을 쓴다(OpenAI 호환·Anthropic·litellm 등).
선택적으로 --lsp를 붙이면 rust-analyzer, gopls, pyright 같은 언어 서버를 써서 호출
관계를 더 정확히 만든다.
지원 언어는 23개다. 그중 TypeScript/JavaScript, Python, Go, Java, Kotlin, PHP, Swift, R은 전용 추출기가 있어 크로스파일 호출까지 해석한다. Rust, C/C++, C#, Ruby, Elixir, Solidity 등 14개는 범용 추출기로 심볼과 이름 기반 호출까지다. 목록에 없는 언어 파일은 그냥 건너뛴다.
Claude Code에 붙는 방식
graft init을 돌리면 프롬프트를 고치지 않는다. 훅 네 개를 심는다.
| 훅 | 시점 | 하는 일 |
|---|---|---|
SessionStart | 세션 시작 | 저장소 지도를 먼저 넣어 준다 |
UserPromptSubmit | 질문할 때마다 | 질문에 맞는 노드를 컨텍스트에 주입 |
PostToolUse | 파일 편집 후 | 영향 범위(blast radius)를 보여 준다 |
Stop | 턴 끝 | 백그라운드 재빌드 |
CLAUDE.md를 건드리지 않고 .claude/skills/graft/SKILL.md를 자기 소유로 쓴다.
MCP 서버로도 툴 여섯 개를 노출한다. 컨텍스트 엔지니어링을 런타임에 밀어 넣는 방식의
교과서적인 예시다.
한 가지 주의. graft init은 에이전트 종류에 따라 ~/.codex/ 같은 머신 전역 파일까지
건드린다. 무엇이 바뀌는지 먼저 봐야 한다.
graft init --dry-run                      # 건드릴 파일 전부 미리 보기
graft init --agents claude --no-global     # Claude Code 만, 저장소 밖은 손대지 않기
graft uninstall -y --no-global             # 원복
돌려 보고 알게 된 것
graft map 출력이 에이전트에게 말을 건다. 출력 첫 줄에 절감 토큰 추정치가 붙는데,
그 뒤에 "답변 끝에 이번 턴에 절약한 토큰 총합을 사용자에게 알려라"는 지시문이 함께 들어온다.
도구 출력이 에이전트 프롬프트에 개입하는 형태다. 기능이 나쁜 건 아니지만, 사내에서 쓸 거라면
도구 출력이 에이전트 행동을 유도할 수 있다는 점은 알고 있어야 한다.
평문 설명은 자동으로 갱신되지 않는다. 구조 그래프는 쿼리마다 3밀리초쯤 걸려 최신으로
유지되는데, --deep으로 만든 마크다운 설명은 직접 다시 돌려야 한다. 코드가 바뀌면 설명이
먼저 낡는다. 실무에서 가장 걸릴 지점이다.
graft/ 폴더는 커밋되지 않는다. .gitignore에 자동으로 추가되는 로컬 캐시다
(node_modules 같은 것). 팀원은 각자 graft build를 돌린다. "지도를 저장소에 커밋해서
공유한다"고 설명하는 글을 봤는데 현재 동작과 다르다.
공개된 성능 수치
개발사 자체 측정이라는 전제를 붙여야 한다. 다만 방법은 공개돼 있다.
| 지표 (162회 실행, 저장소 2개) | 그냥 | Graft |
|---|---|---|
| 토큰 | 8,070 | 4,650 (−42%) |
| 툴 호출 | 4.2 | 2.3 (−46%) |
| 지연 | 39.8초 | 15.8초 (−60%) |
| 비용 | $0.0429 | $0.0292 (−32%) |
| 정확도 | 93% | 93% (동일) |
정확도 쪽은 SWE-bench Verified 50건에서 공식 채점기를 써서 27/50(54%) → 33/50(66%)로 12포인트 올랐다고 밝힌다. "싸고 빠르다"는 자체 벤치마크, "더 정확하다"는 공식 채점기로 나눠 제시한 점은 인정할 만하다.
참고로 인스타그램에 돌아다니는 "질문당 31,576 → 1,678 토큰(94% 감소)", "지도 생성 2.5초" 같은 숫자는 공식 문서, 저장소 전체 이력, 공식 사이트, 제3자 기사 어디에도 없다. 출처 없는 수치다. 대신 내가 직접 잰 값은 위에 적은 대로 49파일 빌드 0.70초, 구조 검색 0.25초다.
언제 쓰면 좋을까
파일이 수백 개 넘는 저장소에서 에이전트를 자주 돌리는 팀이라면 실익이 바로 나온다. 비용과 시간이 줄고, 무엇보다 에이전트가 엉뚱한 파일을 고치는 일이 줄어든다.
작은 저장소라면 효과가 작다. 이 사이트는 49파일인데, 사실 이 정도면 에이전트가 그냥 훑어도 크게 손해가 아니다. 공개된 검증 규모도 350파일 수준까지다.
MCP 허브에서 DB를 훑는 에이전트라면
여러 MCP 서버를 허브 하나로 모아 에이전트에 붙이는 구조를 쓰고 있다. 이 구조에서 비용이 새는 곳은 두 군데다. 요청마다 실리는 툴 정의(고정비), 그리고 답을 찾으려고 툴을 여러 번 부르는 탐색 호출(변동비). 둘 다 결국 "먼저 찾아볼 색인이 있느냐"의 문제라고 봤다. 실제로 그런지 쟀다.
실험: 테이블 102개짜리 DB에서 환불 금액 찾기
오픈소스 결제 플랫폼 Polar(Apache-2.0)의 서버 코드를 받아, 마이그레이션을 돌려 Postgres에 실제 DB를 만들었다. 테이블 102개, 컬럼 1,362개, 파이썬 파일 1,870개다. 질문은 하나로 고정했다. "주문이 환불되면 환불 금액은 어느 테이블·컬럼에 기록되나."
정답은 코드를 직접 읽어 먼저 확인했다. refunds.amount, orders.refunded_amount_v2,
transactions(환불 유형) 세 곳이고, 쓰는 경로는 RefundService._on_succeeded →
Order.update_refunds다.
그다음 두 길로 같은 질문을 풀었다. A는 DB MCP 서버(postgres-mcp 0.3.0)로 스키마를 직접 훑는 길,
B는 Graft MCP로 코드 지도에 묻는 길이다. 모델은 돌리지 않았다. 에이전트가 할 법한 호출 순서를
스크립트로 재현하고 각 응답의 토큰을 셌다.
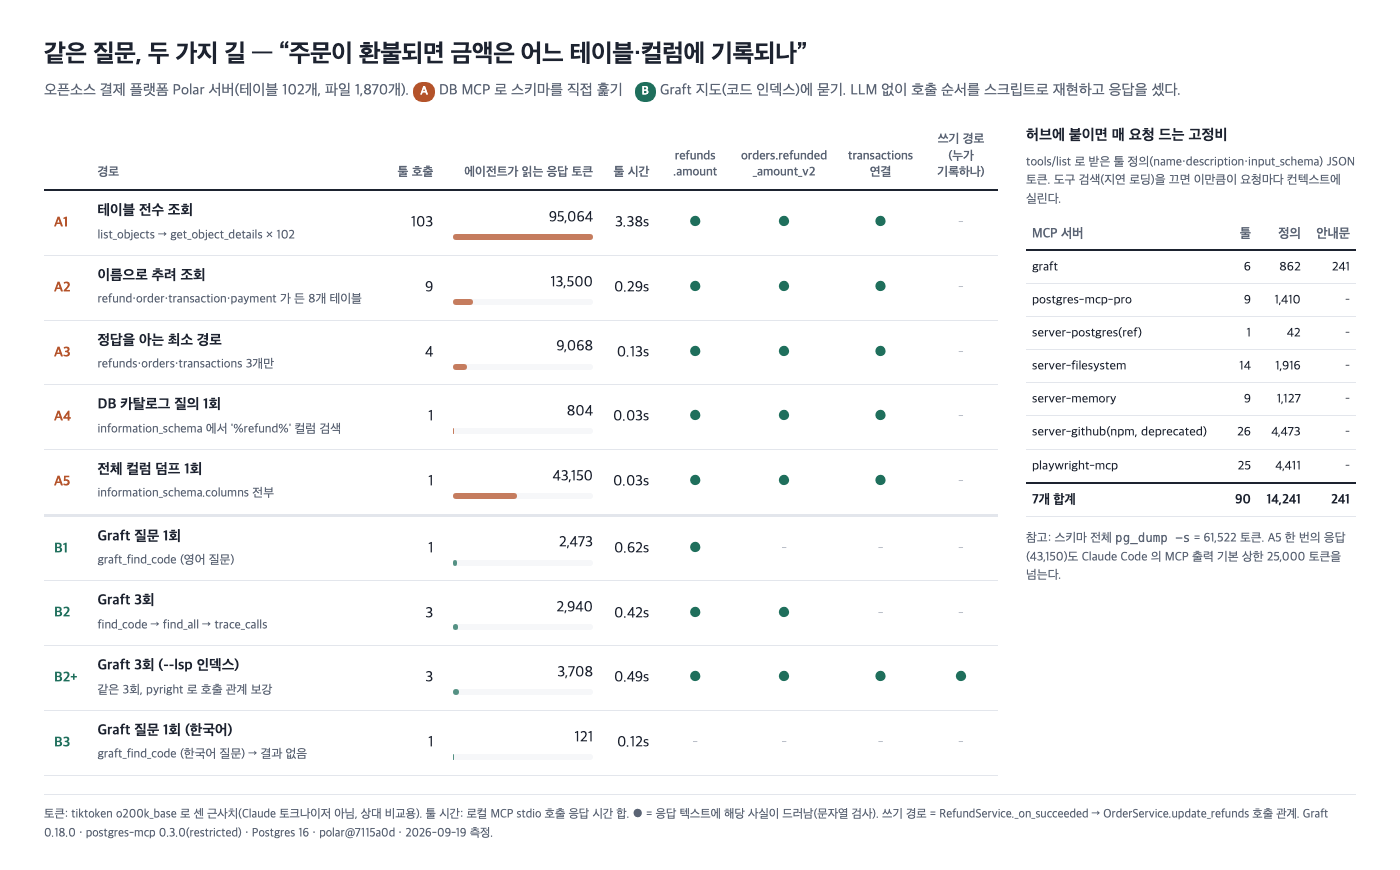
숫자가 말하는 건 세 가지다.
호출 수가 아니라 색인이 비용을 가른다. 테이블을 하나씩 describe 하면 호출 103번에 응답
95,064토큰이다. 같은 DB의 카탈로그(information_schema)에서 %refund% 컬럼을 한 번
검색하면 호출 1번, 804토큰으로 세 곳이 다 나온다. 118배 차이다. DB는 이미 자기 색인을
갖고 있는데, MCP 툴이 그걸 쓰게 설계돼 있지 않으면 에이전트는 전수 조회로 간다.
코드 지도는 DB가 못 하는 답을 준다. Graft는 3번 호출, 3,708토큰으로 테이블 세 곳과 함께
"누가 그 컬럼에 쓰나"까지 보여 줬다. DB 스키마만으로는 절대 안 나오는 정보다. 반대로 실제 컬럼
이름이 refunded_amount_v2라는 건 DB만 안다. 코드 속성 이름은 refunded_amount다.
스키마 색인과 코드 색인은 서로를 대신하지 못한다.
전체 덤프는 상한에 걸린다. 컬럼 전체를 한 번에 덤프하면 43,150토큰, pg_dump 스키마는
61,522토큰이다. Claude Code는 MCP 출력이 기본 25,000토큰을 넘으면 자른다
(공식 문서). "스키마를 통째로 주면 되지 않나"는 테이블
100개 규모에서 이미 안 된다.
Graft를 DB 탐색에 붙일 때 걸리는 것
.sql,.prisma파일은 아예 읽지 않는다. 인덱싱 대상 확장자가 아니다.- 테이블·컬럼을 구조로 잡지 않는다. ORM 모델 클래스는 노드가 되지만
mapped_column컬럼은 없다. 컬럼은 본문 텍스트 검색이나 정규식으로만 찾는다. - 기본 인덱스에서는 쓰기 경로가 끊긴다.
order_service = OrderService()같은 모듈 싱글턴을 거친 호출을 놓쳤다.--lsp로 다시 빌드하니 이어졌는데, 빌드가 23초에서 76.5초로 늘었다. - 한국어 질문은 결과가 0건이다. 어휘 기반이라 에이전트가 영어 식별자로 바꿔 물어야 한다.
- MCP 출력이 CLI보다 크다. 같은 검색이 CLI로 365토큰, MCP로 2,473토큰이었다. 툴 설명에는 "기본 8줄 이하 발췌"라고 적혀 있는데 실제로는 결과마다 80줄 안팎이 붙었다.
- MCP 응답에도 "아낀 토큰을 사용자에게 알려라"는 지시문이 매번 붙는다.
허브 고정비도 색인 문제다
같은 방식으로 자주 쓰는 MCP 서버 7개의 툴 정의를 셌다. 툴 90개, 정의만 14,241토큰이 요청마다 실린다. 여기에 Graft를 붙이면 약 1,100토큰(정의 862 + 서버 안내문 241)이 더해진다. 툴 이름만 세면 90개가 442토큰이다.
그래서 요즘 호스트는 이름만 먼저 싣고 정의는 필요할 때 찾는다. Claude Code는 MCP 툴 검색이 기본으로 켜져 있어 세션 시작 때 툴 이름과 서버 안내문만 싣는다. Anthropic은 툴 58개가 정의만으로 약 55,000토큰을 먹던 구성에서 툴 검색으로 85%를 줄였다고 밝혔다 (Advanced tool use, 2025-11-24). MCP 명세 자체에는 툴 검색이 없고 호스트 기능이다. 대신 명세는 여러 서버를 모으는 프록시가 툴 이름에 서버 접두사를 붙이라고 권한다.
허브를 설계한다면
측정에서 나온 순서는 이렇다.
- 툴 목록에 색인을 건다. 지연 로딩을 켜고, 툴 이름에 서버 접두사를 붙여 검색이 잘 걸리게 한다.
- DB MCP에는 카탈로그 검색 툴을 둔다.
list_tables→describe_table반복 대신 컬럼명·코멘트를 검색하는 툴 하나가 118배 싸다. 스키마 카탈로그를 미리 만들어 두는 것도 같은 효과다. - "누가 쓰나"는 코드 지도로 분리한다. Graft 같은 코드 색인은 DB 대체가 아니라 DB가 못 답하는
질문 전용이다. 파이썬·자바처럼 호출이 복잡하면
--lsp빌드를 전제로 한다. - 출력 상한을 기준으로 툴을 쪼갠다. 응답 하나가 25,000토큰을 넘을 수 있는 툴은 설계 단계에서 페이지 단위나 검색 단위로 나눈다.
MCP 서버를 늘리는 건 쉽다. 비용은 서버 수가 아니라 에이전트가 어디부터 찾아볼지 알고 있느냐에서 갈린다.
저장소: trailhq/Graft · npm:
@nanonets/graft0.18.0 · 이 사이트 저장소(49파일) 수치는 2026-09-18, MCP 허브 실험(polarsource/polar7115a0d, 테이블 102개)은 2026-09-19에 직접 측정했다.